用AI跑生信:哪几步能放手,哪几步必须自己盯
跑通不等于跑对,能出图不等于能写进论文。
今年组会“零代码跑完一整套生信流程”已经不是新闻。像Codex这样的通用Agent可以根据你的语言描述生成分析脚本,在本地部署一个大模型就可以在自己的工作机上运行,而垂直的生信智能体能将质控、比对、聚类、注释、差异分析和富集等过程全部集成起来,最终提供图表、统计表以及可重复的脚本。
问题从来不是“能不能跑通”。跑通是最基本的需求。最要命的是跑是跑了,结果错了,还跑得挺优雅——图出来了,表出来了,p也出来了,只是这个p不该是这个p。生信这行最累人的不是红色报错,而是沉默。
判断一个AI生信工具值不值得信,先不看它出的图漂不漂亮,看它有没有留下“每一步做了什么”的痕迹。
— 01 —
先弄清你手上的工具是哪一类
目前市场上所谓的“AI做生信”,实际上分为三个层次,能力和风险各不相同,混淆概念极易造成误判。第一层:通用编程Agent,例如Codex、各种IDE中的助手。它本质上是“很会写脚本的搭子”,对R、Python、Seurat、DESeq2的API相当熟悉,但它对生信规范一无所知。你给的信息越模糊,它就越会自己补全,而补全的那部分就是风险。
第二层为本地大模型工作站。数据不出内网,适用于样本量大、涉及未发表数据或临床信息的课题组,也适用于反复迭代分析。代价是:环境需要自己维护;模型的规模和显存、内存要配的上任务;装完以后谁都能用,谁都能改,版本的要管理好。
第三层是垂直的生信智能体,像 PaperOK 的生信模式、BioMaster、WorkBuddy 这一类。它们的差别不在“会不会写代码”,而在流程是内置的:会先跟你确认数据集、分组和统计标准,再执行质控、比对、聚类、注释、差异分析与富集,并且每一步记录输入、参数与产物。这一点比跑得快重要得多,因为事后能复盘,才谈得上纠错。
— 02 —
这几件事,可以放心交出去
最成熟的场景是代码生成和改写。把一套手工跑了三遍的过程写成函数,把散乱的几十行脚本组织成一个带参数的可复用项目结构,把旧版本的语法迁移到新版本,给一个循环加上并行——以前需要耗费一两天的工作,现在只需描述清楚后修改两次即可使用。前提是你能看懂它写了什么,至少看关键的20行。
报错排查的命中率也很高。依赖冲突、路径写错、内存溢出、版本对不上、某个包在新系统上装不了,这些都是“有明确答案”的问题,把完整的报错和你的环境信息贴给它,通常几分钟就有方向。注意,它给出的只是一个很可能是正确的猜想,你需要自己运行来验证。
第三类为格式化和渲染:将结果表可视化,将一堆图整合成组会的版式,将方法学写出初稿,将统计表转为投稿要求的形式。这类工作错得起、改得快,给AI干最合适。但是记住,方法学初稿是给你改的草稿,不是可以直接粘进论文的成品。
— 03 —
这四件事,AI 替不了你
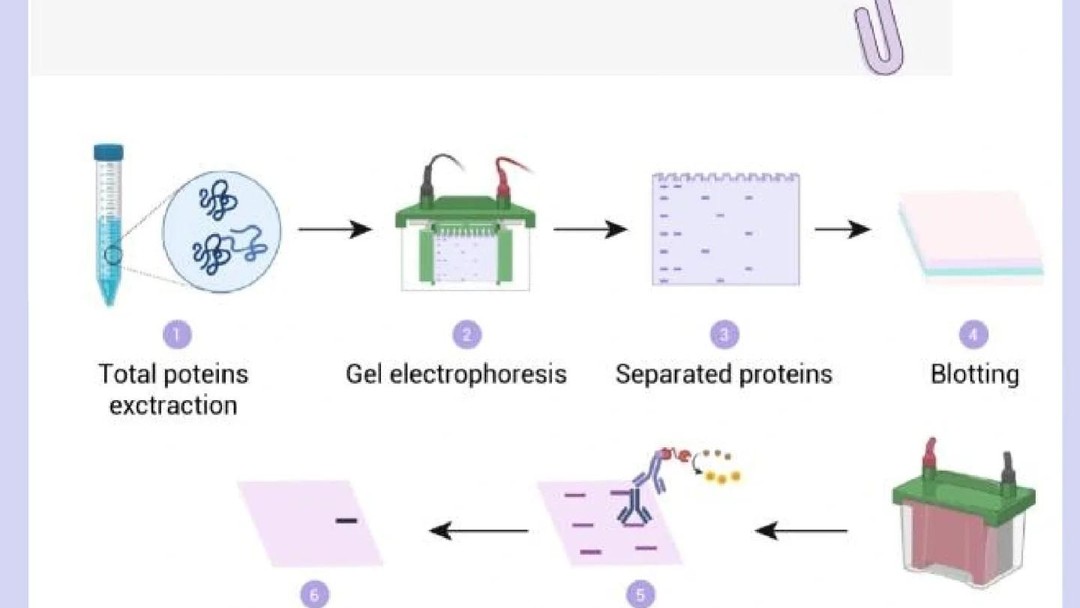
第一件就是数据的的质量的判断。测序质量、比对率、重复性、批次结构、离群样本、单细胞里的双细胞和环境 RNA 污染,这些东西没有一个是“算一下就有答案”的。哪些样本需要剔除?剔除后是否会使得某一个组别被完全剔除?能否通过协变量校正批次差异?这些都需要根据实验设计和样本来源进行判断。AI会老老实实的将质控指标计算给你,但是它不会替你决定“这个样本不能要”。
第二件就是参数和流程的选择,这是默认值陷阱最多的地方。假如你让它做一个bulk RNA-seq的差异分析,你告诉它“按常规做”,可能就直接给你一张padj排好序的表格,至于用的是什么标准化、有无过滤低表达的基因、协变量是否进入模型、多重检验校正方法是什么,都在你没看到的那几行code里了。默认值是他人数据的合理值,不一定就是你的。选择单细胞分析的分辨率、注释的参考集以及物种和基因组版本的正确性同样如此。
第三件为结果检查。至少三件事:自己内部是不是自洽的(比如差异基因方向跟你看的表达量图对不上),换个方法能不能复现(换个标准化换个聚类参数,你的主要结论还能站得住脚吗),和已有的知识是不是冲突(有冲突先怀疑你自己)。这些判断没有捷径可走,也没有哪家工具可以替他们签这个字。
第四件是生物学的解释。富集分析排在最前面的几个通路,AI能写出一段非常通顺的话,但这只是“这些基因和这些通路有关”,而不是“你的数据证明了这件事”。通顺与正确之间有很长的距离,最易使人掉以轻心的就是通顺。
— 04 —
静默出错,长什么样
最近已经有不少文章在讨论这个话题,有人专门写过《生信分析里几个会静默算错的边界与断言写法》。总结起来,最为典型的有这三种。一种是编造:没有的函数参数、像真的一样版本号、写错的物种或者参考基因组,语法上没问题,运行也不会报错,但结果从开始就错了。
第二种是偷偷地换掉。它发现某个包没装、某个数据库连不上,换一种实现或者降级处理,流程继续往下走,但是口径发生了变化。你不看日志的话,你都不知道中间换过什么。第三类是版本漂移,注释数据库更新后,同一脚本3个月后执行,基因数量对不上。
对付它们,最有效的办法就是让AI顺便写“断言”。几个关键点:样本数与设计表是否相符、是否出现组别标签反了、表达矩阵NA比例、组内相关系数是否有异常、前后基因数差异分析是否对。断言不能解决问题,但它可以使沉默的错误发出声音,并使流程在错误发生时停止,而不是让它运行到末尾并返回一个漂亮的错误图像。
— 05 —
一份可以照着做的审核清单
将以上这些落子动作其实很简单。每次AI出图,先检查以下几点,可以帮你规避掉很多低级且致命的错误。
☐ 样本与分组
合格:进入分析的样本数、分组标签和设计表完全符合。不合格:少了一个样本没人发现或者对照组和实验组反了。
☐ 关键参数
合格:能解释清楚选择阈值、标准化方法、协变量、校正方式的原因。不合格:只会回答“工具默认的”。
☐ 版本与参考
合格:基因组版本、注释库版本、软件版本均记录在脚本或记录中。不合格:仅写“人类基因组”。
☐ 中间产物
合格:每一步的输入、输出文件齐全,可单独重新运行。不合格:只剩最后一张最终图,中间被遮住了。
☐ 换法复现
合格:换一种合理方法,主要结论方向不变。不合格:结论只在某一组参数下成立。
☐ 解释的措辞
合格:写的是“与……相关”“提示……可能参加”。不合格:写成“证明”“导致”。
说到底,人机分工很明确:能用文字说明白、能马上验证对错的活,交给AI;需要你来担责的判断,自己来。脚本、报错、排版是前者,数据要不要、参数合不合适、结论站不站得住是后者。将这两种事情混合起来交给一个工具才是真正危险的。
如果你不想从零搭环境,也可以先用现成的垂直智能体试手。比如 PaperOK 的生信模式会先和你确认数据集、分组和统计标准再往下跑,每一步都留输入、参数和产物,交付时给出图表、统计表、报告和可复现脚本——正好对应上面清单里要核的那些东西。用它跑一遍流程,再拿清单去对,比自己啃命令行快很多。
AI 帮你省下的时间,
最后都要花在核验上。
关于 PaperOK科研助手 · 生信模式
运行在你电脑上的 AI 生信搭档:25 个生信插件覆盖基因组、转录组、单细胞、空间组学与蛋白质组。一句话描述研究问题,自动完成数据下载、质控、分析与报告,交付图表、统计表和可复现脚本。
论文查重、AIGC检测全部免费
科研AI工具,助你顺利毕业
 扫码关注公众号